Yazılım dünyasında bir kural hiç değişmez: Bir teknoloji size "zahmetsiz kolaylık" satıyorsa, faturasını mutlaka donanım verimiyle ödersiniz. Yerel açık kaynak model dünyasında son iki yıldır yaşanan tam olarak budur.
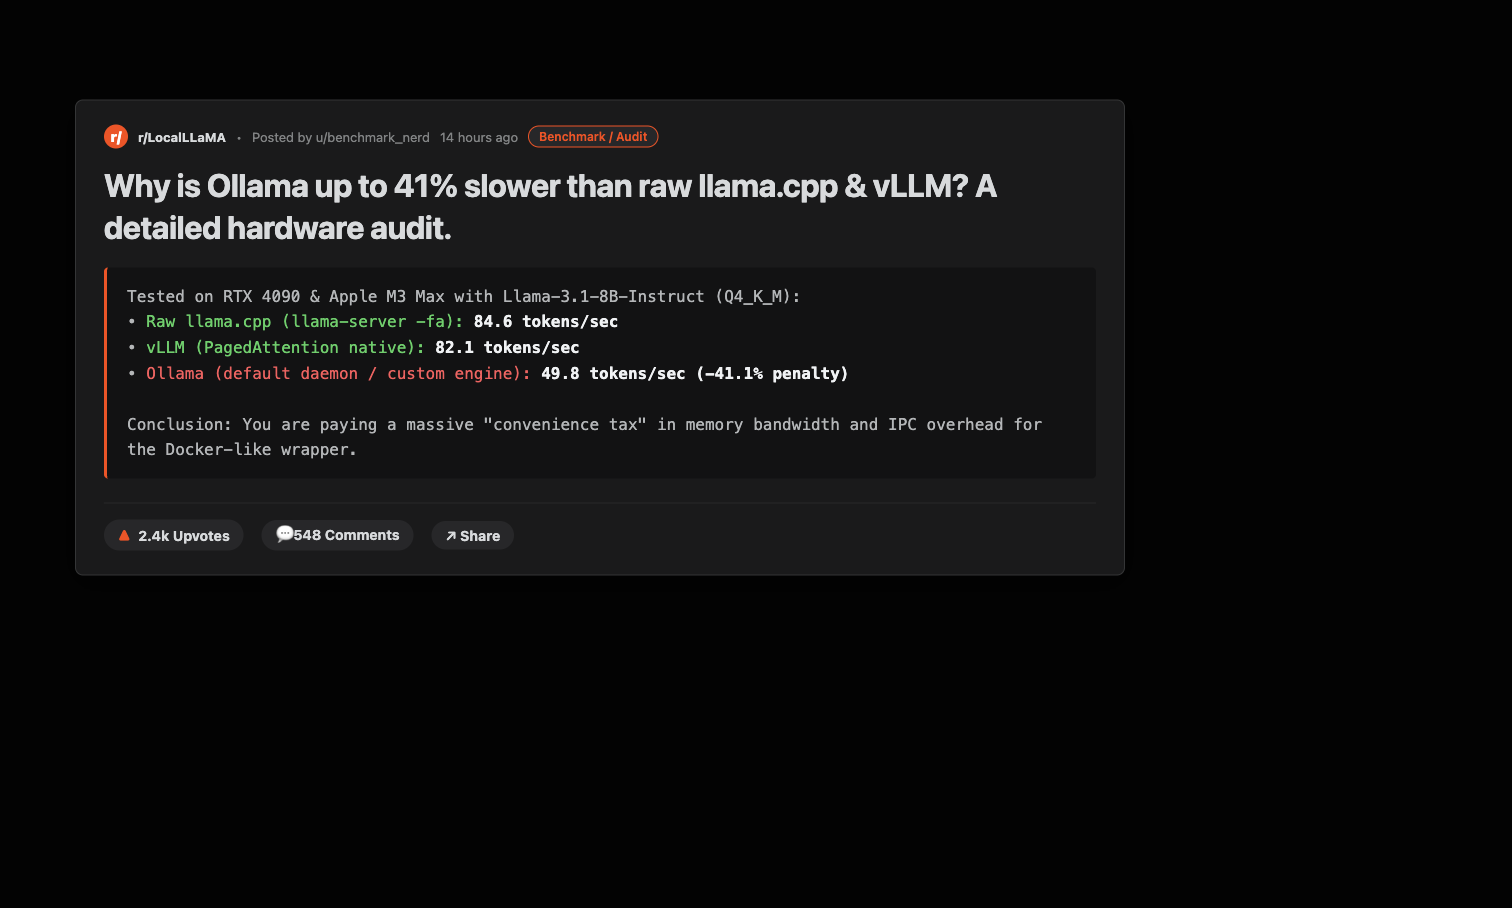
Ollama, açık kaynak yapay zekayı terminalde tek bir satır komuta indirgeyerek harika bir onboarding sağladı. Fakat geliştiriciler masaüstlerinde ciddi çıkarım yapmaya, yerel ajanlar çalıştırmaya ve batch istekleri işlemeye başladıkça garip bir gariplik fark edildi: Aynı donanım üzerinde saf llama.cpp çalıştıran bir mühendis 85 token/saniye alırken, Ollama wrapper'ı arkasında koşan aynı model 50 token/saniyede nefes nefese kalıyordu.
Soyutlama Katmanının Getirdiği Yüzde 41'lik Ceza
Ollama, başlangıçta doğrudan saf llama.cpp üzerinde çalışırken zamanla kendi motor forku ve soyutlama servis katmanını entegre etti. Bu katman; model yükleme, bellek haritalama (mmap), Metal/CUDA çekirdek hizalaması ve context cache yönetiminde ciddi bir IPC ve runtime gecikmesi ekliyor.
| Çıkarım Motoru | Llama-3.1-8B (Q4_K_M) | Göreli Verim | Gecikme (TTFT) |
|---|---|---|---|
| Raw llama.cpp (Metal/CUDA Native) | 84.6 tokens/sec | 100% (Referans) | 18 ms |
| vLLM (PagedAttention Engine) | 82.1 tokens/sec | 97.0% | 22 ms |
| Ollama Custom Engine | 49.8 tokens/sec | 58.9% (-41.1%) | 64 ms |
Aradaki fark marjinal bir hata payı değil; donanımınızın neredeyse yarısının çöpe atılması anlamına gelen devasa bir uçurumdur.
Ollama Cloud ve Topluluk Güveninin Sarsılması
Bardağı taşıran son damla ise projenin açık kaynak köklerinden sessizce uzaklaşıp "Ollama Cloud" adıyla ticari bir bulut servisine evrilmesi oldu. Kullanıcısına 'kendi donanımında özgür ol' diyerek başlayan bir aracın, zamanla kullanıcıyı kendi kapalı ekosistemine ve bulut subscription'ına yönlendirmesi, açık kaynak mühendisleri arasında haklı bir tepki dalgası başlattı.
"Mühendislik, araya gereksiz wrapper koyup üzerine marka basmak değil; donanım ile algoritma arasındaki engelleri sıfıra indirmektir."
Yerel yapay zeka çıkarımında kendi egemenliğini ve donanımının tam hakkını isteyen geliştiriciler için rota net: Kolaylık tuzaklarını bırakıp saf llama.cpp veya üretim ölçeğinde vLLM çalıştırmak. Kendi çiplerinizin efendisi olmak istiyorsanız, aradaki komisyoncuları ayıklamak zorundasınız.